我把知识库搬进了断网的笔记本:13 万星的 llama.cpp 实测,CPU 每秒 39 个字
当前位置:点晴教程→知识管理交流
→『 技术文档交流 』
01 先说那个不敢上传的文件夹每个做技术的人手里都有几个这种文件夹:客户名单、内部接口文档、家里的证件扫描件、写了半年的日记。 放云端 NotebookLM 很方便,但那几个文件夹,你不敢拖进去。AI 联网服务再怎么承诺加密,文件一上传就离开了你的硬盘,这件事本身没有回头路。 所以真正的问题是:能不能在断网的状态下,让 AI 回答你文件夹里的问题。 答案是可以,而且不需要买显卡。这篇是我在这台 8 线程的 Intel 笔记本上,把一套「不联网知识库」从零跑通的全过程,每一步都带数字。 02 整套东西只有三层先把架构说清楚,后面所有实测都按这三层走:
为什么推理层选 llama.cpp 而不是 Ollama?Ollama 底下跑的就是 llama.cpp,多包了一层服务和管理界面;LM Studio 是闭源 GUI。裸引擎的好处是你知道每一个字节从哪来,而且它的 Windows 预编译包只有 24MB,解压就能跑。
03 装:24MB 拆开看从 Releases 下载 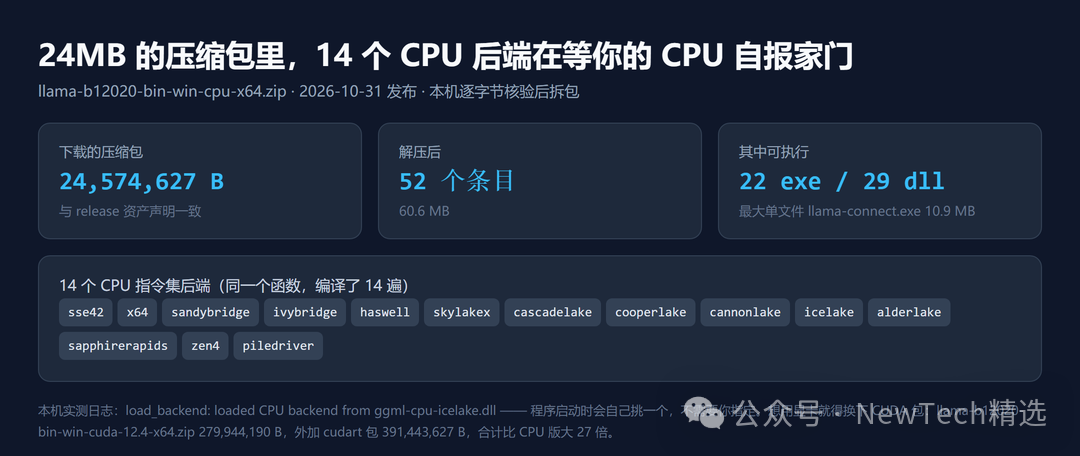
最有意思的是那 14 个 想用显卡就得换 CUDA 包:主包 279,944,190 字节,外加一个 cudart 包 391,443,627 字节,合计比 CPU 版大 27 倍。没有 N 卡的话,CPU 版就是全部。 04 实测一:检索这层先说结论:这一层完全成立,但中文的准确率没有想象中高。 llama.cpp 的包里没有单独的嵌入工具,嵌入由 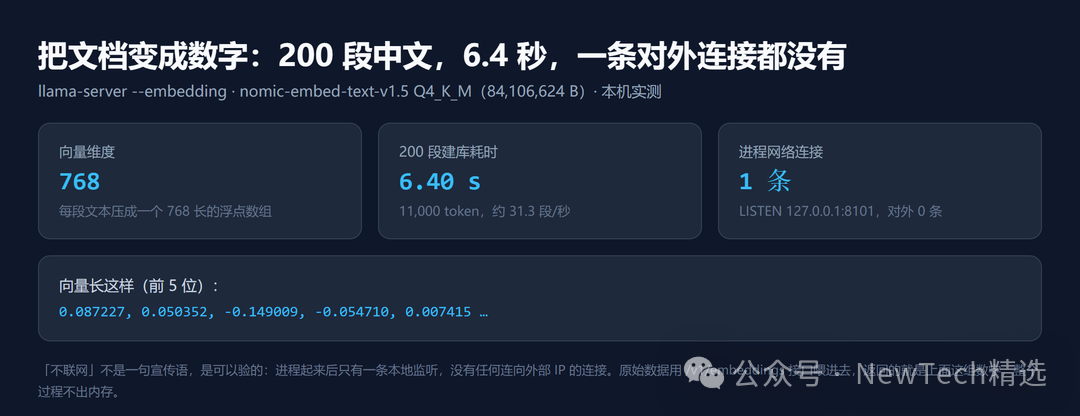
「不联网」这句宣传是可以验证的。我用 psutil 数了这个进程的全部网络连接:1 条, 然后是最关键的问题:检索准不准。我写了 10 条互不相同的知识入库,出了 5 个问题,用余弦相似度排序:
整个脚本只有三步:文本切块、调 一个 10 条知识的小库尚且如此,几百段真实文档更得靠 Top3 兜底。这一步如果你只想验证可行性,100 行 Python 就够了,不必急着上重型框架。 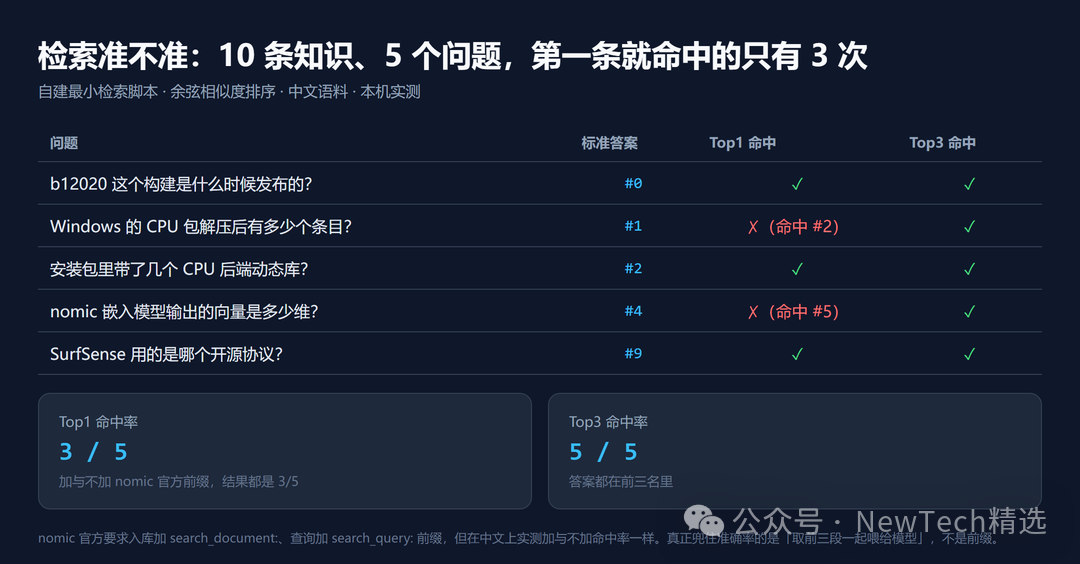
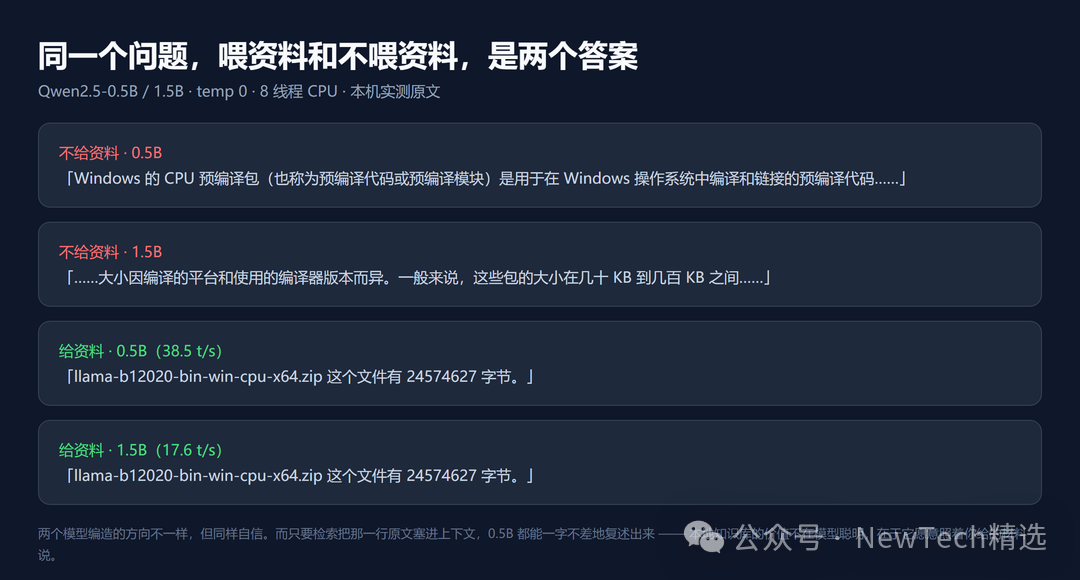
05 实测二:喂资料前后,模型判若两人我用 Qwen2.5 的 0.5B 和 1.5B 两个量化模型做了同一组对照,问题是一个只有资料里才有答案的细节:某个 zip 文件有多少字节。 不给资料时,两个模型都编,且编的方向完全不同:0.5B 说预编译包是"用于编译和链接的预编译代码",1.5B 说"一般在几十 KB 到几百 KB 之间"。语气都很自信。换一个更日常的问题,0.5B 甚至把 RAG 解释成了"React Native App 的缩写"。 把检索到的三段资料塞进上下文之后,两个模型都一字不差地答出了 24574627 字节。0.5B 用了 38.5 t/s,1.5B 用了 17.6 t/s。 llama-bench 的标准数据更能说明取舍(8 线程 CPU): pp 是读资料,tg 是逐字生成。知识库场景里读资料是大头,而回答往往就几十个字,所以 0.5B 的体验反而更好:加载 3.5 秒、常驻内存 495.7 MiB、一次问答 0.75 秒。 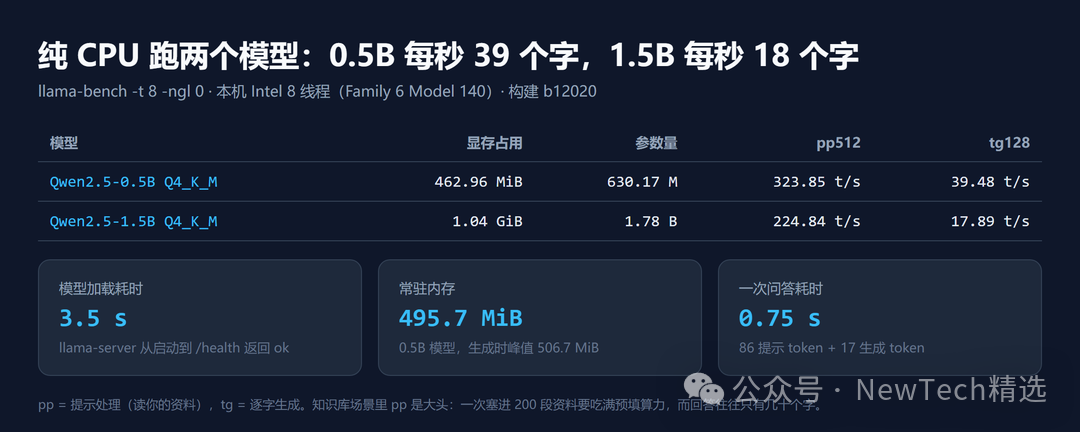
06 最后一块:把界面接上去到这一步,底座是两个命令行服务。要让它变成"知识库",还差一个能拖文件的界面。 SurfSense 的 README 里有一句关键的话,是它在对比 NotebookLM 时写的:模型支持「任意兼容 OpenAI 的 API,或本地模型」,文档「不会离开你的电脑,除非你选择远程模型」。而 llama-server 起的恰好就是 OpenAI 兼容服务,本机实测 也就是说,把 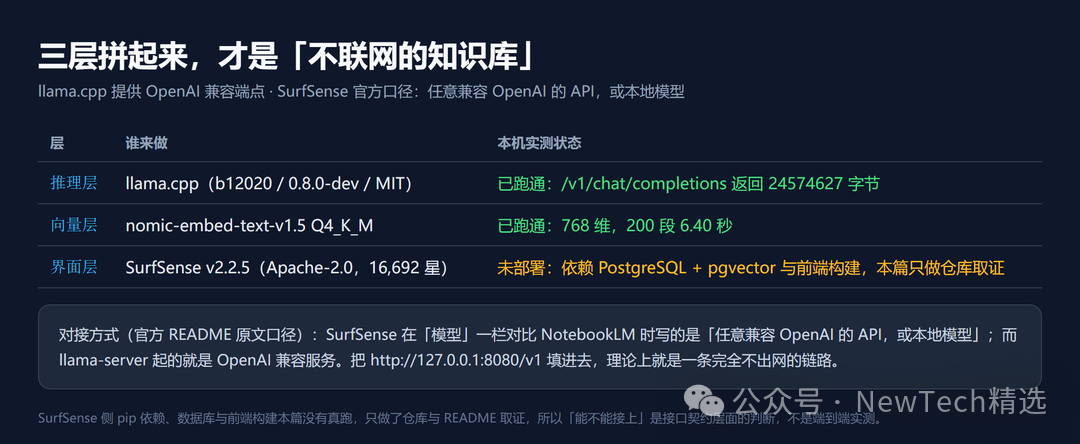
但要如实说明:SurfSense 依赖 PostgreSQL 加 pgvector 和一层前端构建,这篇没有真把它部署起来,对接判断来自接口契约和仓库取证,不是端到端实测。它能吞的格式不少:PDF(含扫描页 OCR,认中文)、Word、Excel、PowerPoint、CSV、图像、Markdown,还有录音转写。它有 10 个官方插件(网页抓取、YouTube、Reddit 这些),那部分需要许可证,14 天免费。 07 什么时候别用它
总结评价推荐指数:⭐⭐⭐⭐☆(扣一星:纯 CPU 的中文生成质量还撑不起"直接出答案",得靠资料喂) 一句话:llama.cpp 是本地 AI 的地基,24MB、免安装、MIT,检索和生成两层都能在这台笔记本上真跑通。 适用人群:手里有不敢上传的文档、能接受 20 t/s 生成速度、愿意写百来行脚本的人。 不适用人群:想要开箱即用图形界面的、需要强推理能力的、以及指望它在纯 CPU 上复现云端体验的。 阅读原文:点击这里 该文章在 2026/11/4 9:42:16 编辑过 |
关键字查询
相关文章
正在查询... 

|


 400 186 1886