亿级表分库分表:实操步骤、最佳实践与注意事项
当前位置:点晴教程→知识管理交流
→『 技术文档交流 』
 单表过亿,不是神话,是很多业务迟早会撞上的墙。DDL 锁表动辄几十分钟,备份恢复按天计,索引再建不起,大查询把从库拖垮——这时候再谈「加机器、加索引」往往只是止痛。真正的手术是分库分表:把一张巨型表拆成可运维的物理单元。 这篇不讲空概念,直接按生产实操写:什么时候该拆、分片键怎么选、架构怎么摆、迁移怎么灰度、哪些坑一次踩够。坐稳,开拆。
什么时候该拆:信号比「行数」更重要行数过亿是参考,不是硬门槛。更该看这些信号是否同时出现:
若主要痛点是「复杂报表 / 多维分析」,优先把分析流量切到数仓或搜索引擎,别把 OLTP 表硬拆成「能搜但不能联表」的一堆碎片。分库分表解决的是在线交易规模,不是 BI。 整体架构:应用 → 路由中间件 → 多库多表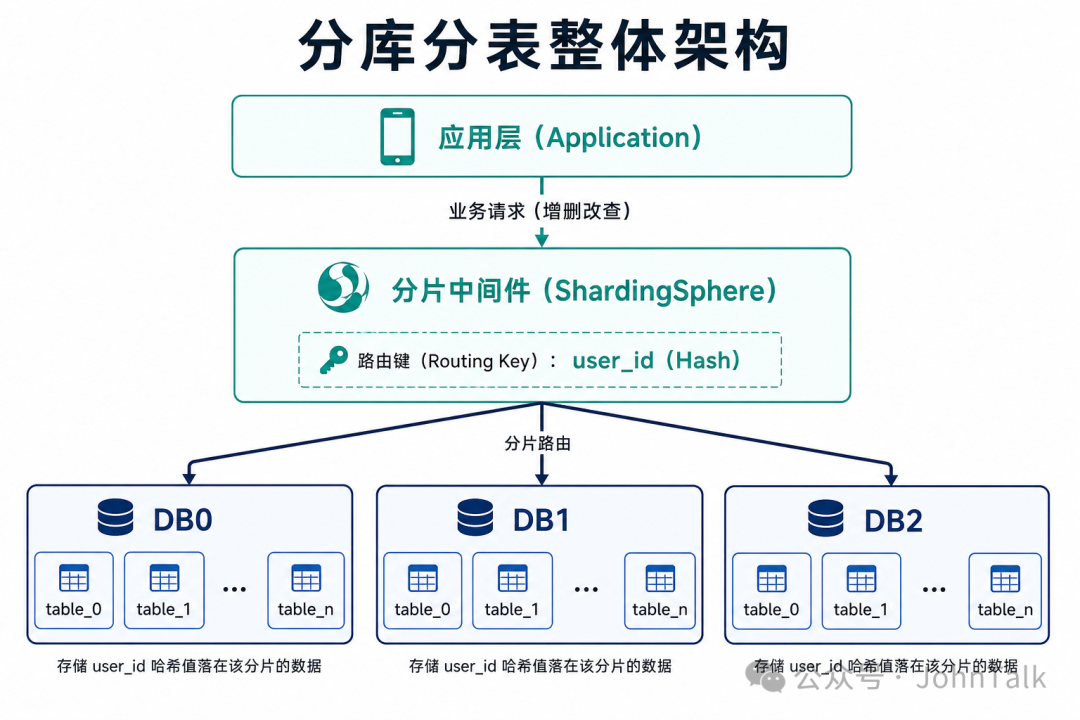 常见落地形态:业务仍写「逻辑表」名,由 ShardingSphere / 自研路由层 / Proxy 按分片键算到物理库表。库内再拆多张表,避免单表过大;库与库之间分散连接、磁盘与备份压力。 只分表不分库:适合单机磁盘与连接还够、主要是单表过大。实现简单,但主机天花板还在。分库又分表:适合写入与存储都顶满。成本与运维复杂度显著上升,规划时一次性把容量余量留足,避免半年后再二次拆。 分片键与策略:选错一次,全局返工分片键是命根子。好的分片键满足三条:高频查询几乎都带它、基数够大且分布均匀、业务上尽量不变更。用户域常用
实操建议:先按「未来 2~3 年峰值」估算分片数,一次到位或按 2 的幂预留,少做「先 8 张再 32 张」的二次迁移。单表目标可按业务定:例如单表行数千万级、数据文件几十~一两百 GB 内,DDL 与备份仍可控。 ShardingSphere JDBC 风格的最小配置示例(逻辑示意,库表名按环境改): spring: shardingsphere: datasource: names: ds0,ds1 ds0: jdbc-url: jdbc:mysql://db0:3306/order_db ds1: jdbc-url: jdbc:mysql://db1:3306/order_db rules: sharding: tables: t_order: actual-data-nodes: ds$->{0..1}.t_order_$->{0..7} table-strategy: standard: sharding-column: user_id sharding-algorithm-name: order-table-mod database-strategy: standard: sharding-column: user_id sharding-algorithm-name: order-db-mod 路由算法可简化理解为: table_index = (user_id / 2) % 8 # 或统一:hash(user_id) % (2 * 8) 再映射到库表 实操步骤:按这个顺序走,少开事故会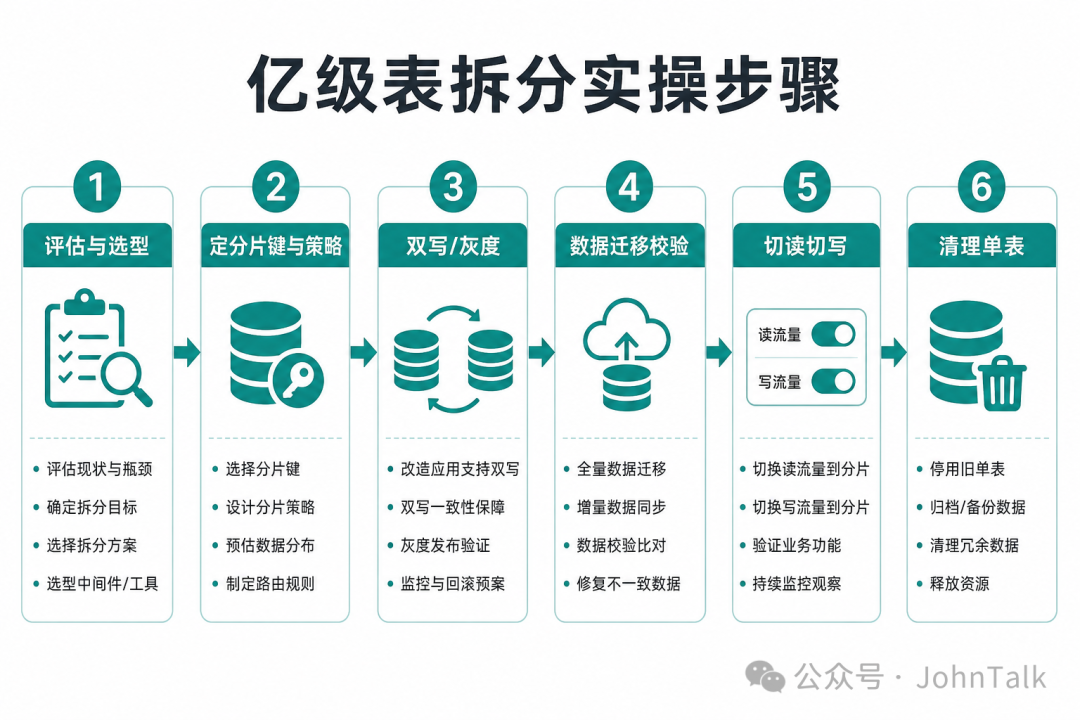
迁移任务伪代码节奏(生产必须限流、可断点续跑): last_id = 0 batch = 1000 while True: rows = SELECT * FROM t_order WHERE id > :last_id ORDER BY id LIMIT :batch if not rows: break for row in rows: route = shard(row.user_id) INSERT INTO route.db.route.table ... ON DUPLICATE KEY UPDATE ... last_id = rows[-1].id sleep(throttle_ms) # 保护在线库 校验至少做两层:行数对齐(按分片键聚合对比)与字段抽样/哈希(关键列 MD5)。只比 count 不够,漏写、错路由、半更新都会被 count 骗过。 全局 ID、事务与查询:拆完之后的三座大山全局唯一 ID:别再依赖单库自增。常见方案:号段模式(Leaf)、Snowflake 类、UUID(存储与索引更差)、或「分片号 + 本地序列」。订单号最好自带路由信息(或可反解出 user_id),否则客服查单、对账会哭。 事务:同库同片尽量本地事务;跨片用最终一致(本地消息表、Outbox、可靠消息)优先于强一致 XA。下单扣库存这类,优先通过业务设计把关键写收敛到同一分片键。 查询:带分片键的点查/列表是舒适区;后台「按手机号查全部订单」要么倒排索引表,要么同步到 ES。跨片分页用 最佳实践清单(可直接贴进技术方案)
注意事项与踩坑:每一条都值钱坑 1:分片键选了会变的字段。用户换绑、订单改归属,路由漂移导致数据找不到或重复。分片键应近似不可变。 坑 2:以为中间件能透明兼容所有 SQL。跨库 JOIN、子查询、部分聚合、事务边界都会踩雷。上线前用真实 SQL 清单做兼容性测试。 坑 3:只迁数据不改分页/报表。管理后台一查全站订单,广播到所有分片,CPU 集体起飞。后台查询要单独产品方案。 坑 4:双写不一致无对账。切流当天才发现从库少单。对账任务要在灰度期每天跑,差异可回放。 坑 5:扩容用「取模改 N」硬切。大量数据要搬家。提前预分片,或采用一致性哈希 / 扩容工具链,并把扩容演练写进预案。 坑 6:忽略连接池与配置翻倍。10 个库 × 每库连接池,应用侧连接打满数据库。 坑 7:DDL 在所有分片上手搓。缺一张表、少一个索引就会局部故障。用变更平台批量执行,并做结构一致性巡检。 什么时候可以不拆:更便宜的选项
能垂直拆、能归档、能把分析打出去,就别急着上水平分片。分库分表是「买扩展性」,同时「卖」简单性。 结语亿级表分库分表,可以收成一条作战链:先确认值得拆 → 选对分片键与容量 → 改访问模式 → 双写迁移对账 → 切读切写可回滚 → 监控与归档常态化。技术细节可以换成不同中间件,但这条顺序别跳。 下次评审有人只说「表太大了,分 64 张」,你可以追问三句:分片键是什么?无分片键查询怎么处理?切流怎么回滚?答得清,方案才算站得住。 全文完。 阅读原文:原文链接 该文章在 2026/10/21 12:28:51 编辑过 |
关键字查询
相关文章
正在查询... 

|


 400 186 1886