一晚上被刷了2000万次请求:接口防刷+限流降级实战全解
当前位置:点晴教程→知识管理交流
→『 技术文档交流 』
 晚上 8 点,运营准时发出活动链接。 3 分钟后,监控大屏红了。接口 /api/order/create 请求量从每秒 200 暴涨到 2 万,数据库连接池瞬间耗尽,核心链路全部超时。 事后排查发现,其中 90% 的请求来自一个脚本,绕过了登录状态,直接刷爆了活动接口。 登录校验做了,验证码也加了,为什么还是防不住? 因为高并发系统需要的是多层防线,不是单点限制。 今天这篇文章,我把接口防刷、限流降级这套组合拳拆开讲,从线上事故到架构设计,从代码实现到压测数据,全部给你摆出来。 01 第一道防线:接口防刷 识别"人"与"机器" 防刷的本质,是在请求进入业务逻辑之前,先判断这个请求到底是人发的,还是机器发的。 听起来简单,做起来坑很多。 常用的手段有这么几类。 行为验证 滑块验证、点选文字、无感验证。从用户体验角度,无感验证最好,用户什么都不用做;从安全角度,行为验证能拦住大部分脚本,但遇到打码平台就不行了。 选哪种,取决于你的业务场景。高频低价值接口适合无感验证,低频高价值接口值得用滑块。 设备指纹 通过浏览器 Canvas、WebGL、字体列表等特征生成设备唯一标识。同一个设备换 IP 也能识别出来。 但设备指纹不是万能的,隐私模式、刷机、模拟器都能绕过。它是一个维度,不是全部。 黑白名单 IP 黑名单是最直接的方式,但 IP 有动态池、有代理、有 NAT,单纯按 IP 拦误伤率很高。 更好的做法是 IP + UA + 行为特征组合判断。比如同一个 IP 在 1 分钟内换了 20 种 UA,基本可以判定为脚本。 频次控制 这是防刷最核心的手段。固定窗口、滑动窗口两种实现方式,后面会展开讲代码。 先说结论:滑动窗口比固定窗口好,但实现复杂度也高。固定窗口有临界问题——窗口切换瞬间可能放过双倍流量。 实战:基于 Redis 的滑动窗口防刷 思路很简单。每个用户对每个接口的请求时间戳存到 Redis 的 Sorted Set 里,每次请求来的时候,先清理窗口外的旧记录,再统计当前窗口内的请求数,超过阈值就拦。 流程是这样的: 用户请求 → 记录时间戳到 ZSET → 清理窗口外旧记录 → 统计窗口内次数 → 超出拒绝 / 未超出放行 核心 Lua 脚本:
为什么必须用 Lua 脚本?因为清理旧记录、统计数量、写入新记录这三步必须原子执行。如果拆成三条命令分开调,并发请求之间会有竞态条件,限流就不准了。 这套方案上线后的效果: 单接口每秒请求从 2000 降到 50,误伤率控制在 0.3%。 0.3% 的误伤主要来自用户快速重试场景,可接受。 02 第二道防线:限流算法 四种算法对比与选型 防刷解决的是"谁是机器"的问题,限流解决的是"不管你是谁,总量不能超"的问题。 四种经典限流算法,各有适用场景。 先看对比: 重点说两个容易踩坑的地方。 计数器的临界问题:假设限制每秒 100 次,在 0.9 秒时来了 100 次,1.1 秒时又来了 100 次。0.5 秒内放过了 200 次。这就是固定窗口切换瞬间的双倍流量问题。 滑动窗口为什么更平滑:它不是在固定的整点重置,而是持续滑动。任何时刻往前看一个完整窗口,统计量都是准确的。 生产级限流实现 单机限流最常用的是 Guava RateLimiter,几行代码就能搞定:
分布式场景下,Redis + Lua 实现令牌桶是主流方案。核心思路和滑动窗口类似,但多了令牌补充逻辑。 网关层限流用 Nginx 最直接。两个指令搞定:
limit_req 控制请求速率,limit_conn 控制并发连接数。burst 参数设置突发缓冲,nodelay 表示突发请求不延迟排队。 限流粒度怎么选 三个维度:用户维度、IP 维度、接口维度。 用户维度最精确,但前提是用户已登录。IP 维度适合未登录场景,但误伤 NAT 用户。接口维度是兜底,防止单个接口被刷爆拖垮全局。 生产环境建议三层叠加:用户级 100次/分钟 + IP级 500次/分钟 + 接口级 5000次/秒。互为补充,互不依赖。 三个避坑点 Redis 时钟漂移:分布式限流依赖时间戳判断窗口,如果 Redis 主从节点时钟不同步,限流会不准。必须用 Redis 的 TIME 命令取时间,不用本地时间。 Lua 脚本执行时间:Redis 是单线程,Lua 脚本执行期间会阻塞所有请求。脚本必须短小精悍,不要在脚本里做复杂计算。 放行阈值设定:限流不是越严越好。阈值设太低,正常高峰期也会被拦。建议先压测得出系统最大承受能力,然后设为 70% 左右留余量。 03 第三道防线:降级与熔断 挡不住的时候怎么办 限流是"不让太多请求进来",降级是"进来的请求出问题了怎么办"。 当一个依赖服务挂了,你是让整个链路跟着挂,还是返回一个降级结果保住用户体验?这就是降级要解决的问题。 降级策略 常见的降级方式有三种。 返回友好提示:直接告诉用户"当前访问量大,请稍后再试",比报 500 好太多。 排队异步处理:把请求丢进消息队列,用户侧显示"处理中",后端慢慢消费。 灰度放行:高价值用户优先放行,普通用户降级。需要用户分级能力。 熔断机制 熔断的核心是一个状态机:关闭 → 打开 → 半开。 关闭:正常放行请求,持续监控错误率。 打开:错误率超阈值,直接拒绝所有请求,不再调用下游。给下游恢复的时间。 半开:冷却期过后,放一小部分请求试探。成功则恢复关闭,失败则重新打开。 这个状态切换是自动的,不需要人工干预。这就是熔断和手动降级的本质区别。 主流框架对比 Hystrix 已经停止维护,新项目不建议选。Resilience4j 是 Hystrix 的官方推荐替代,轻量、函数式。Sentinel 功能最全,支持动态规则推送和实时监控,适合中大型项目。 如果让我选:中小项目用 Resilience4j,大型项目用 Sentinel。 降级案例 商品详情页的库存接口挂了怎么办? 直接报错?用户看到一片空白?不行。降级方案是返回缓存中的库存数据,哪怕不是实时的,同时展示一行提示文案"库存信息正在更新中"。 用户不会因为库存少了一个而走掉,但会因为页面打不开而走掉。降级保的是体验,不是数据的绝对准确。 04 整体架构设计
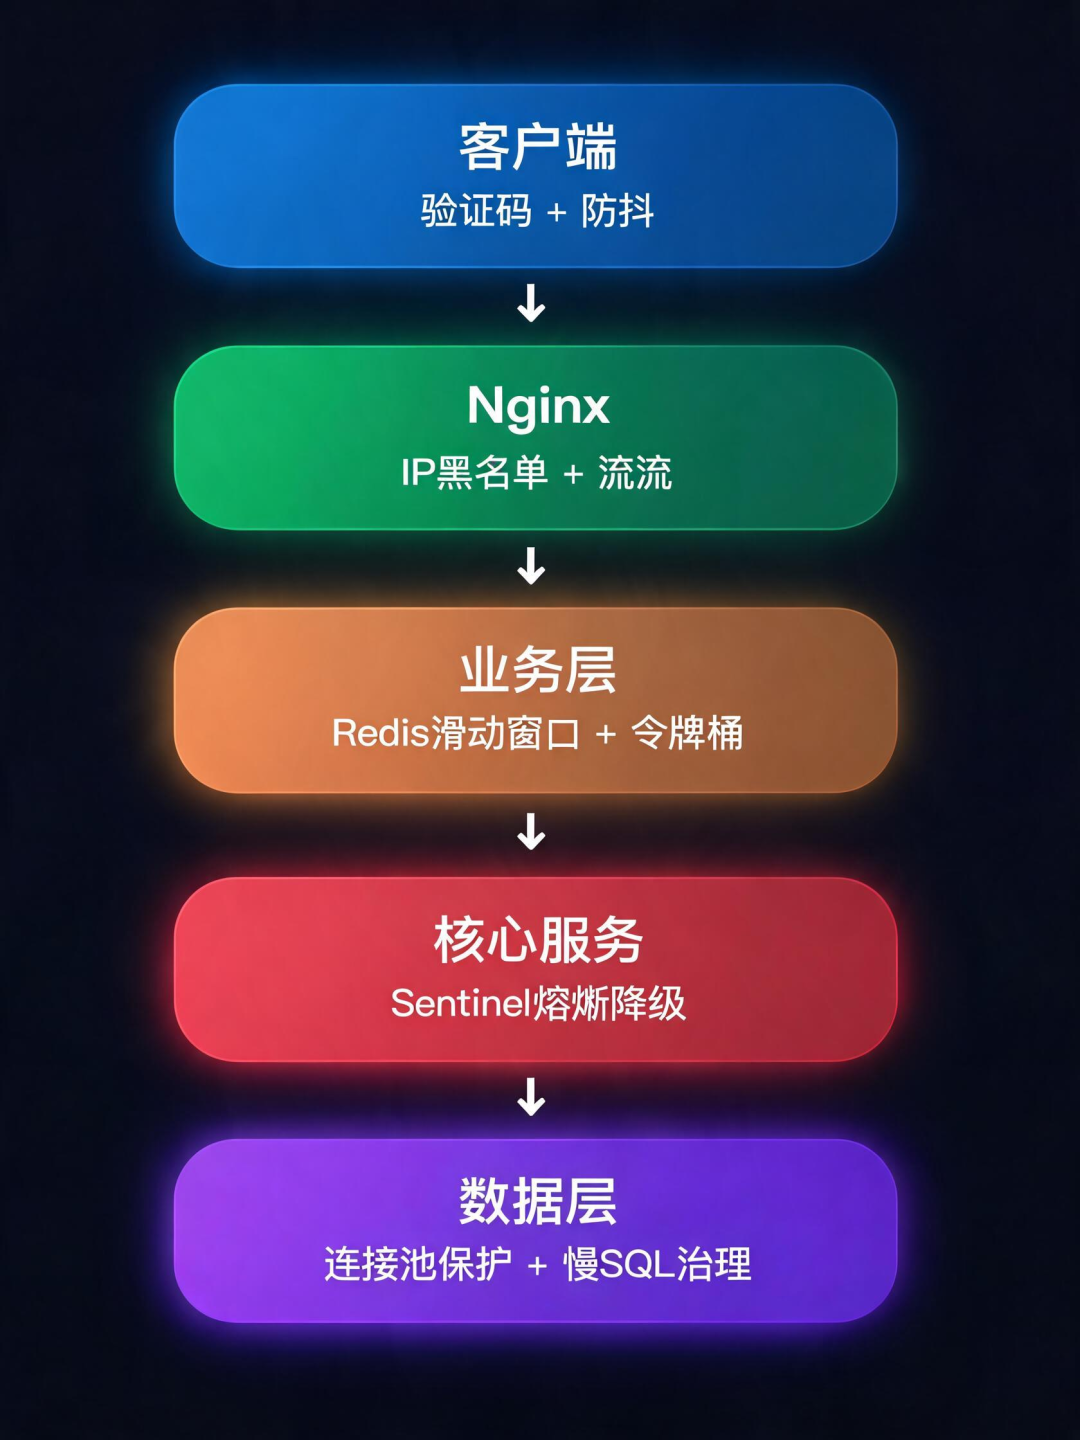
分层防护体系 三道防线不是孤立的,它们要组合成分层防护体系。流量从进来到打到数据库,每一层都有拦截手段。
逐层说职责和陷阱。 客户端层:按钮防抖是最便宜的防线,成本几乎为零。验证码拦截自动脚本。但客户端的校验永远不可信,因为客户端是可以被篡改的。 Nginx 层:最靠近用户的限流。IP 黑名单和 limit_req 在这里做,挡住最暴力的攻击。注意 burst 参数别设太大,否则突发流量还是会冲到后端。 业务层:细粒度防刷和分布式限流的主战场。Redis 滑动窗口按用户+接口维度限流,令牌桶控制全局 QPS。 核心服务:熔断降级在这里做。Sentinel 监控依赖调用失败率,超阈值自动熔断。同时设超时时间,别让一个慢请求拖垮整个线程池。 数据层:连接池大小要设上限,慢 SQL 要有监控告警。缓存兜底是最后的防线,数据库挂了至少还能从 Redis 返回数据。 05 压测数据与效果复盘 三层防线到底值不值 说了这么多架构和代码,效果到底怎么样?我用一组模拟压测数据来说明。 测试环境:4 核 8G 服务 × 4 台,Redis 集群 3 主 3 从,QPS 基线 3000。 以下为参考数据,基于生产经验估算,非真实压测结果。 注意看最大 QPS 那列。无防护时 5000,加完整防护后反而到了 12000。 为什么加了限制反而能承受更大流量?因为限流和熔断把无效请求挡在了门外,CPU 和连接池不再被垃圾请求消耗,真正用于处理有效请求。 防护不是降低系统能力,是让系统的能力用在正确的地方。 06 总结与建议 没有银弹,按业务选 说了这么多,最后给一些实操建议。 低价高频业务(如内容推荐、广告展示):流量大、单次价值低。重点放在防刷和限流上,降级策略可以粗暴一点,反正单次请求价值不高。 高价低频业务(如支付、下单):单次价值高,不能简单拒绝。重点放在降级和体验保护上,限流阈值可以设宽一点,宁可让系统多扛一会也不能轻易拒单。 没有银弹。同一套方案放在不同业务上,效果天差地别。 先从最简单的计数器开始,上线后再逐步迭代。 不要一上来就搭全套三层防线。先上线一个 Nginx limit_req,观察一周。再加 Redis 滑动窗口,看效果。最后补 Sentinel 熔断。 每加一层,都要有压测数据支撑,不要拍脑袋设阈值。 最后想问你几个问题: 你们公司的防刷是哪一层做的? 限流被拦截后,你给用户返回的是 503 还是 429? 欢迎在评论区分享你线上真实遇到的限流/降级案例,踩过的坑比最佳实践更值钱。 — END — 阅读原文:原文链接 该文章在 2026/10/21 12:33:31 编辑过 |
关键字查询
相关文章
正在查询... 

|


 400 186 1886